抖音视频没有字幕,怎么把口播提取成文字?
视频里有可识别的人声,即使画面没有打字幕,也可以通过语音识别把口播转成文字。但人说的话、画面上的字和作者写的配文,可能是三份不同的内容。你想记下的是哪一份,要先分清楚。
操作步骤
在具体视频里复制分享链接
打开想提取的那条抖音作品,点“分享”→“复制链接”。复制出来带着标题、口令和网址也没关系,可以粘贴整段分享文字;别只复制一句标题,也别把博主主页当成这条视频的链接。
粘贴到抖音文案提取页,先处理一条
打开视频说的“抖音文案提取”页面,粘贴分享文字,登录后提交。先选一条你确实想整理、能够公开访问的视频,看看文字是否覆盖了要记的内容,再决定是否批量处理。不需要为了这一步先下载视频,也不需要安装命令行工具。
从任务记录看结果,留着时间轴校对
在任务记录里打开这次任务。完成后先看全文,遇到拿不准的名字、数字或一句话的意思,再按分段时间回到原视频核对。任务还在处理时先等原任务,不要连续提交同一条。
先看一份真实结果,知道转完该检查哪里
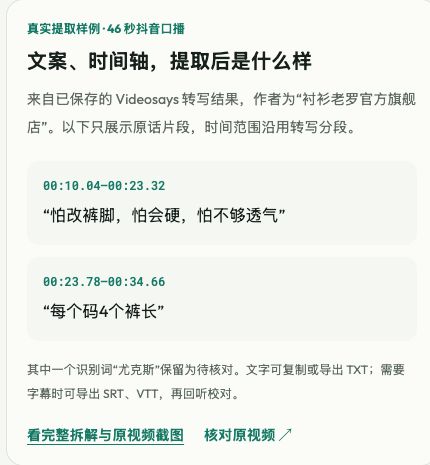
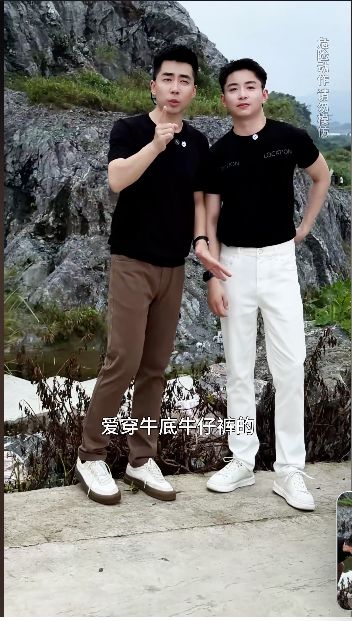
下面这份公开样例来自“衬衫老罗官方旗舰店”的一条 46.255 秒牛仔裤口播。已有转写把全文分成四段,每段带时间。比如要核对一个没听清的面料词,可以直接回到 00:10.04–00:23.32 这一段,而不是从头找。
这张截图来自视频说页面上的真实结果节选,不是把文字套进一张虚构的任务界面。它用来演示结果阅读和校对;原片本身有画面文字,不把它当成“无字幕视频”的实测证明。
先听一句:你需要的是口播,还是画面上的字?
如果你想要的是主播完整说了什么,找语音转写。视频没有打字幕,也可以从声音生成文稿。
如果你想要的是画面中的价格表、手写板或几行说明,找画面文字识别,也就是 OCR。比如主播只说“尺寸看这里”,具体长宽只出现在画面上,语音转写不能凭这句话补出尺寸。
如果你只是想复制作者发布时写的那一小段介绍,查看作品的配文即可。它可能只有一句话,不能当作整条视频的口播稿。
没有画面字幕,为什么仍然能得到文字?
字幕可以是画面里已经压进去的字,也可以是平台单独提供的字幕数据。两者都没有时,仍然可以尝试识别视频里的声音,生成文字。
视频说的自动模式会优先使用可获取的原始字幕,没有可用字幕时再尝试语音识别。这个过程不是把画面里的字抄下来,也不会自动把口播翻译成另一种语言。能否得到可用结果,还取决于源视频能否访问、人声是否清楚。
转完别急着润色,先查这四处
第一是名字和专业词。人名、品牌名、型号听起来相近时,单看一句通顺的文字未必能发现错;对不上就标“待核对”,保留对应时间点。
第二是数字和单位。把价格的小数点、容量、日期和百分比分开看,数字后面的“元”“毫升”“天”也要核对。第三是否定词:“不要加水”和“要加水”只差一个字,操作却反了。
第四是指代。遇到“这个”“上面那种”“按这里”,回到画面确认指的是什么。把它写成笔记时补清楚对象,别让一段看似完整的文字留下关键空白。
记笔记用全文,做字幕还要看时间
只想阅读、搜索或整理笔记,复制全文或保存 TXT 就够了。记得一起留原链接,后面核对某句话时不用重新找视频。
要放进剪辑软件做字幕,在结果有分段时间轴时选择 SRT 或 VTT。它们保留字幕段落和时间,但仍是需要校对的草稿。正文对了,字幕也可能断在不方便阅读的位置;导入后再看一遍实际播放效果。
提取不了,先判断是链接问题还是声音问题
如果任务提示无法访问,先回原平台打开这条具体视频,确认没有删除、转私密或复制错来源,再看任务给出的失败原因。自己登录后能看见,不等于处理服务也能公开访问;反复提交同一个受限链接通常不能解决这个问题。
如果任务完成了,但缺句、错词多,就回听原声:背景音乐有没有盖住人声,是不是几个人同时说话,关键信息是不是只出现在画面里。原声本来就听不清的地方,先留下疑点,不要让后续的 AI 总结把猜测写成确定的答案。
核对来源
- 校对示例原视频:衬衫老罗官方旗舰店 — 使用已有的 46.255 秒转写结果及原片局部截图作校对示例,不据此证明无字幕识别率,也不验证商品信息。
- 视频说:抖音文案提取与导出说明 — 2026-11-13 核对:公开分享链接的提交方法、文字与时间轴、TXT/SRT/VTT 导出,以及公开视频访问和人声清晰度的限制。
找一条能听清人声的视频试试
先提取全文,再挑一句包含数字或专有名词的话回听核对。确认结果适合你的用途后,再处理更多视频。
常见问题
视频原本没有字幕,也能导出 SRT 吗?
如果语音识别成功,并且结果包含分段时间轴,就可以导出 SRT 字幕草稿。它是根据识别结果生成的字幕,不等于拿到了作者制作的原字幕文件。发布前仍要核对文字、断句和时间。
只有背景音乐和画面文字的视频怎么办?
如果没有需要识别的人声,就改用画面文字识别(OCR)。例如把文字清楚出现的画面截下来识字,再逐页核对顺序;动态字幕要覆盖完整内容,不能只截一张就当作全文。视频说当前不是画面 OCR 工具。